酷猫猫配音 · 批量任务接口文档
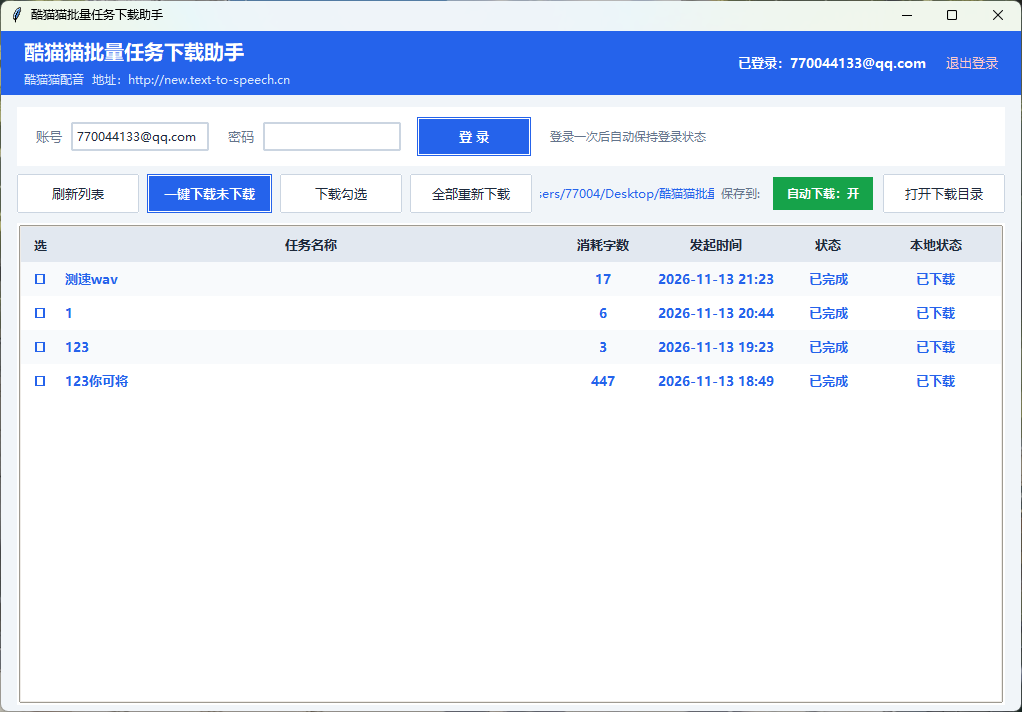
面向自行开发客户端的开发者。本接口只做「登录 → 拉任务列表 → 拿下载地址」
| 站点 | http://new.text-to-speech.cn |
| 接口地址 | http://new.text-to-speech.cn/wp-content/plugins/batch-tts/api.php |
| 接口版本 | 1.1 |
| 返回格式 | JSON(Content-Type: application/json; charset=utf-8) |
一、通用约定
1. 请求方式
所有接口都用 action 参数指定动作,参数可以放在URL 查询串、POST 表单或 JSON 请求体,三种任选其一,服务端都能读到:
GET  api.php?action=ping
POST api.php   (表单:action=login&username=..&password=..)
POST api.php   (JSON:{"action":"login","username":"..","password":".."})
推荐统一用 POST + 表单 或 POST + JSON。
2. 返回结构
{ "code": 200, "msg": "说明文字" }
code与 HTTP 状态码一致;业务数据也在同一个 JSON 里,不额外包一层 data- 成功用
code == 200判断,失败直接把 msg 展示给用户
| code | 含义 |
|---|---|
| 200 | 成功 |
| 400 | 参数缺失(如没填账号密码) |
| 401 | 账号密码错误 / token 无效或过期 |
| 404 | action 不存在 |
| 429 | 密码错误次数过多(同一 IP 10 分钟内累计 8 次) |
| 500 | 服务端异常(如没找到 WordPress 环境) |
3. 字符编码
请求与响应统一 UTF-8。中文任务名、字幕内容都按 UTF-8 处理。
二、接口列表
| action | 用途 | 需要 token |
|---|---|---|
| ping | 健康检查,判断接口是否可用 | 否 |
| login | 账号密码换取 token | 否 |
| tasks | 获取任务列表(含下载地址) | 是 |
三、接口明细
1. ping — 健康检查
请求:GET api.php?action=ping
{
  "code": 200,
  "msg": "接口正常",
  "version": "1.1",
  "site": "http://new.text-to-speech.cn",
  "time": "2026-11-13 20:12:33"
}
建议客户端在「保存服务器地址」或「上报错误」时带上 version,方便排查版本不一致。
2. login — 登录换取 token
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| username | string | 是 | 站点登录名(WordPress 用户名) |
| password | string | 是 | 站点登录密码 |
{
  "code": 200,
  "msg": "登录成功",
  "token": "9f2c8b7a1d4e5f60a1b2c3d4e5f60718a9b0c1d2e3f40516",
  "user": {
    "id": 12,
    "name": "demo",
    "display": "演示账号"
  },
  "vip": ""
}
token 规则
- 48 位十六进制字符串
- 有效期 30 天,每次调用 tasks 会自动续期(滑动过期),常用就不会掉线
- 同一账号重新登录会签发新 token,旧 token 立即失效
- token 等同于登录凭证,请勿写进前端页面、公开仓库或分享给别人
限流:同一 IP 连续输错 8 次密码,锁定 10 分钟,期间返回 429。
3. tasks — 获取任务列表
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| token | string | 是 | login 返回的 token |
{
  "code": 200,
  "count": 2,
  "tasks": [
    {
      "taskId": "b1f2c3d4-5e6f-7890-abcd-ef1234567890",
      "bigname": "第1集",
      "num": "1200",
      "time": "2026-11-13 20:12:33",
      "status": "已完成",
      "result": "https://stttsprodcus210.blob.core.windows.net/.../results.zip?sv=2024-05-04&sig=..."
    },
    {
      "taskId": "c2e3d4f5-6a7b-8901-bcde-f12345678901",
      "bigname": "第2集",
      "num": "980",
      "time": "2026-11-13 19:50:02",
      "status": "生成中",
      "result": ""
    }
  ]
}
字段说明
| 字段 | 类型 | 说明 |
|---|---|---|
| taskId | string | 任务唯一 ID,用于去重、记录「已下载」 |
| bigname | string | 任务名称;建任务时没填则为「未设置」 |
| num | string | 该任务消耗的字数(注意是字符串) |
| time | string | 提交时间,格式 YYYY-MM-DD HH:mm:ss |
| status | string | 任务状态,见下表 |
| result | string | 下载地址(ZIP),未完成时为空字符串 |
status 取值
| 取值 | 含义 | 客户端处理建议 |
|---|---|---|
| 生成中 | 微软还在合成 | 显示「生成中」,等下次轮询 |
| 已完成 | 已生成完毕,result 有值 | 可以下载 |
| 失效 | 下载地址过期或任务不存在 | 提示用户到网页端重新提交 |
其它约定
- 只返回最近 3 天的任务,与网页端一致
- 排序为新 → 旧(最新的在最前面)
- 状态与下载地址由站点自己的定时任务更新,本接口只读,不会触发微软查询,也不会重复扣费
- 列表是全量快照,客户端应自己维护「已下载 taskId 集合」做去重
四、下载与文件处理规范
result 指向一个 ZIP 压缩包(Azure Blob 的 SAS 直链),下载时:
- 不要加站点 Cookie / 鉴权头,直接 GET 即可
- 有效期约 3 天,过期后 status 会变为「失效」,需要重新生成
- 走微软直链,不经过站点服务器
1. 压缩包内部结构
results.zip
  ├─ 0001.mp3              音频(也可能是 0001.wav,取决于任务输出格式)
  ├─ 0001.sentence.json    分句数据(用于生成字幕)
  ├─ 0001.word.json        逐字时间戳(一般用不到)
  ├─ 0001.debug.json       调试信息(丢弃)
  ├─ summary.json          汇总(丢弃)
  └─ 0002.mp3 / 0002.*     文案过长被切成多段时出现,编号递增
- 音频文件名是固定编号,跟任务名无关,所以必须自己改名
- 一个任务可能只有 0001.*,也可能有 0002.*、0003.*…… 按编号顺序对应原文顺序
- 音频扩展名可能是 .mp3,也可能是 .wav,以压缩包内实际为准
2. 重命名规则(建议与官方客户端一致)
- 取出所有音频文件(.mp3 .wav .m4a .ogg .flac .aac .opus .wma),按文件名排序
- 第 1 个 → 任务名.扩展名,第 2 个 → 任务名_2.扩展名,第 3 个 → 任务名_3.扩展名
- 扩展名保持原样(是 wav 就存 wav,不要强行改成 mp3)
- 任务名里的非法字符(\ / : * ? " < > |)替换成下划线
- 任务名末尾如果已经带了音频后缀,先去掉再拼,避免出现「测速wav.wav」
- 不同任务名相同时,用 taskId 后 6 位加后缀,避免互相覆盖
示例:任务名「第1集」,包内 0001.wav + 0002.wav
第1集/第1集.wav
第1集/第1集_2.wav
3. 字幕生成(0001.sentence.json → 0001.srt)
0001.sentence.json 是分句数组,典型内容:
[
  { "Text": "你好,世界。", "AudioOffset": 50, "Duration": 3525 },
  { "Text": "这是第二句。", "AudioOffset": 3600, "Duration": 2000 }
]
| 字段 | 说明 |
|---|---|
| Text | 该句文本 |
| AudioOffset | 该句开始时间,单位毫秒 |
| Duration | 该句持续时长,单位毫秒 |
转换规则(与官方客户端、getSrt 插件完全一致):
- 序号从 1 递增,跳过 Text 为空的条目
- 起止时间:开始 = AudioOffset,结束 = AudioOffset + Duration
- 时间格式:HH:MM:SS,mmm(毫秒三位,用逗号分隔),例 00:00:03,575
- 每条之间空一行
- 文件编码 UTF-8,建议带 BOM,换行用 CRLF(Windows 播放器、剪映、PR 兼容性最好)
- 字幕文件名与音频同名:第1集.wav → 第1集.srt
- 压缩包里没有 0001.sentence.json 时,跳过字幕,只输出音频
生成结果示例:
1
00:00:00,050 --> 00:00:03,575
你好,世界。

2
00:00:03,600 --> 00:00:05,600
这是第二句。
4. 中间文件
word.json、debug.json、summary.json 等对使用者没有价值,解压后建议直接丢弃,只保留音频和 .srt。
五、代码示例
curl
# 1. 健康检查
curl -s "http://new.text-to-speech.cn/wp-content/plugins/batch-tts/api.php?action=ping"

# 2. 登录
curl -s -X POST "http://new.text-to-speech.cn/wp-content/plugins/batch-tts/api.php?action=login" \
     -d "username=你的账号" -d "password=你的密码"

# 3. 任务列表
curl -s -X POST "http://new.text-to-speech.cn/wp-content/plugins/batch-tts/api.php?action=tasks" \
     -d "token=上一步返回的token"
Python(含下载 + 改名 + 字幕)
import io, json, os, re, zipfile
import requests

API = "http://new.text-to-speech.cn/wp-content/plugins/batch-tts/api.php"
AUDIO_EXTS = (".mp3", ".wav", ".m4a", ".ogg", ".flac", ".aac", ".opus", ".wma")


def call(action, **params):
    r = requests.post(API, params={"action": action}, data=params, timeout=60)
    data = r.json()
    if data.get("code") != 200:
        raise RuntimeError(data.get("msg") or ("HTTP %s" % r.status_code))
    return data


def srt_time(ms):
    ms = int(ms)
    s, ms = divmod(ms, 1000)
    m, s = divmod(s, 60)
    h, m = divmod(m, 60)
    return "%02d:%02d:%02d,%03d" % (h, m, s, ms)


def build_srt(raw):
    items = json.loads(raw.decode("utf-8-sig", "ignore"))
    blocks, idx = [], 1
    for it in items:
        text = (it.get("Text") or "").strip()
        if not text:
            continue
        start = int(it.get("AudioOffset") or 0)
        dur = int(it.get("Duration") or 0)
        blocks.append("%d\n%s --> %s\n%s\n" % (idx, srt_time(start), srt_time(start + dur), text))
        idx += 1
    return "\r\n".join(blocks)


def safe_name(name):
    name = re.sub(r'[\\/:*?"<>|\r\n\t]', "_", str(name)).strip().strip(".")
    return name[:120] or "未命名任务"


def extract(zip_bytes, out_dir, task_name):
    os.makedirs(out_dir, exist_ok=True)
    with zipfile.ZipFile(io.BytesIO(zip_bytes)) as zf:
        entries = [(os.path.basename(i.filename), zf.read(i)) for i in zf.infolist() if not i.is_dir()]

    lookup = {n.lower(): d for n, d in entries}
    audios = sorted([e for e in entries if e[0].lower().endswith(AUDIO_EXTS)], key=lambda x: x[0].lower())
    for idx, (inner, data) in enumerate(audios, 1):
        ext = os.path.splitext(inner)[1].lower()
        stem = os.path.splitext(inner)[0]
        base = task_name
        for a in AUDIO_EXTS:                      # 去掉任务名里已有的音频后缀
            if base.lower().endswith(a):
                base = base[:-len(a)]
                break
        target = base + ext if idx == 1 else "%s_%d%s" % (base, idx, ext)
        with open(os.path.join(out_dir, target), "wb") as f:
            f.write(data)
        raw = lookup.get((stem + ".sentence.json").lower())
        if raw:
            srt = build_srt(raw)
            if srt:
                with open(os.path.join(out_dir, os.path.splitext(target)[0] + ".srt"), "w",
                          encoding="utf-8-sig", newline="") as f:
                    f.write(srt)


if __name__ == "__main__":
    token = call("login", username="你的账号", password="你的密码")["token"]
    for task in call("tasks", token=token)["tasks"]:
        if task["status"] != "已完成" or not task["result"]:
            continue
        print("下载", task["bigname"])
        blob = requests.get(task["result"], timeout=300).content
        extract(blob, os.path.join("下载", safe_name(task["bigname"])), safe_name(task["bigname"]))
        print("  完成 ->", task["taskId"])
JavaScript / Node
const API = "http://new.text-to-speech.cn/wp-content/plugins/batch-tts/api.php";

async function call(action, body = {}) {
  const form = new URLSearchParams(body);
  const res = await fetch(`${API}?action=${action}`, { method: "POST", body: form });
  const data = await res.json();
  if (data.code !== 200) throw new Error(data.msg || `HTTP ${res.status}`);
  return data;
}

const { token } = await call("login", { username: "你的账号", password: "你的密码" });
const { tasks } = await call("tasks", { token });
console.log(tasks.filter(t => t.status === "已完成"));
六、接入注意事项
- 轮询频率:建议 ≥ 60 秒一次,不要秒级狂刷;网页端与接口共用一个任务文件,过度请求没有意义。
- token 安全:token 30 天有效且自动续期,属于敏感凭证,只放在自己的程序里,别放进网页前端。
- 下载去重:接口返回的是全量列表,务必自己记录已下载的 taskId,否则每次都会重复下载。
- 下载地址会过期:拿到「已完成」后尽快下载,超过约 3 天会变成「失效」。
- 不要内置微软密钥:本接口的下载地址是站点签发的临时链接,客户端不需要也不应该持有密钥。
- 并发:同一账号同时下载多个大文件容易被微软限速,建议串行(官方客户端就是一个个下)。
- 文件名合法性:Windows 文件名不能含 \ / : * ? " < > |,任务名可能包含这些字符,务必过滤。
七、错误排查对照表
| 现象 | 可能原因 | 处理 |
|---|---|---|
| 401 账号或密码错误 | 账号或密码不对 | 用网页端能登录的账号密码 |
| 429 密码错误次数过多 | 同 IP 10 分钟内错了 8 次 | 等 10 分钟 |
| 401 缺少登录令牌 | 没传 token | 先调 login |
| 401 登录状态无效 / 已过期 | token 失效(重新登录过或被清理) | 重新 login |
| 404 未知接口 | action 拼错 | 只能是 ping / login / tasks |
| 500 未找到 WordPress 环境 | api.php 被移动出了插件目录 | 放回 wp-content/plugins/batch-tts/ |
| 下载 403 / 401 | 下载地址已过期 | 让用户重新生成任务 |
| 解压报错 | 下载不完整(网络中断) | 重新下载 |
接口只读、不改动任何任务数据,随便调用不会扣费。如果你在开发中遇到文档没覆盖的情况,把请求参数和返回的 JSON 发给我们即可。